

無検閲モデルは「ダークAI」なのか
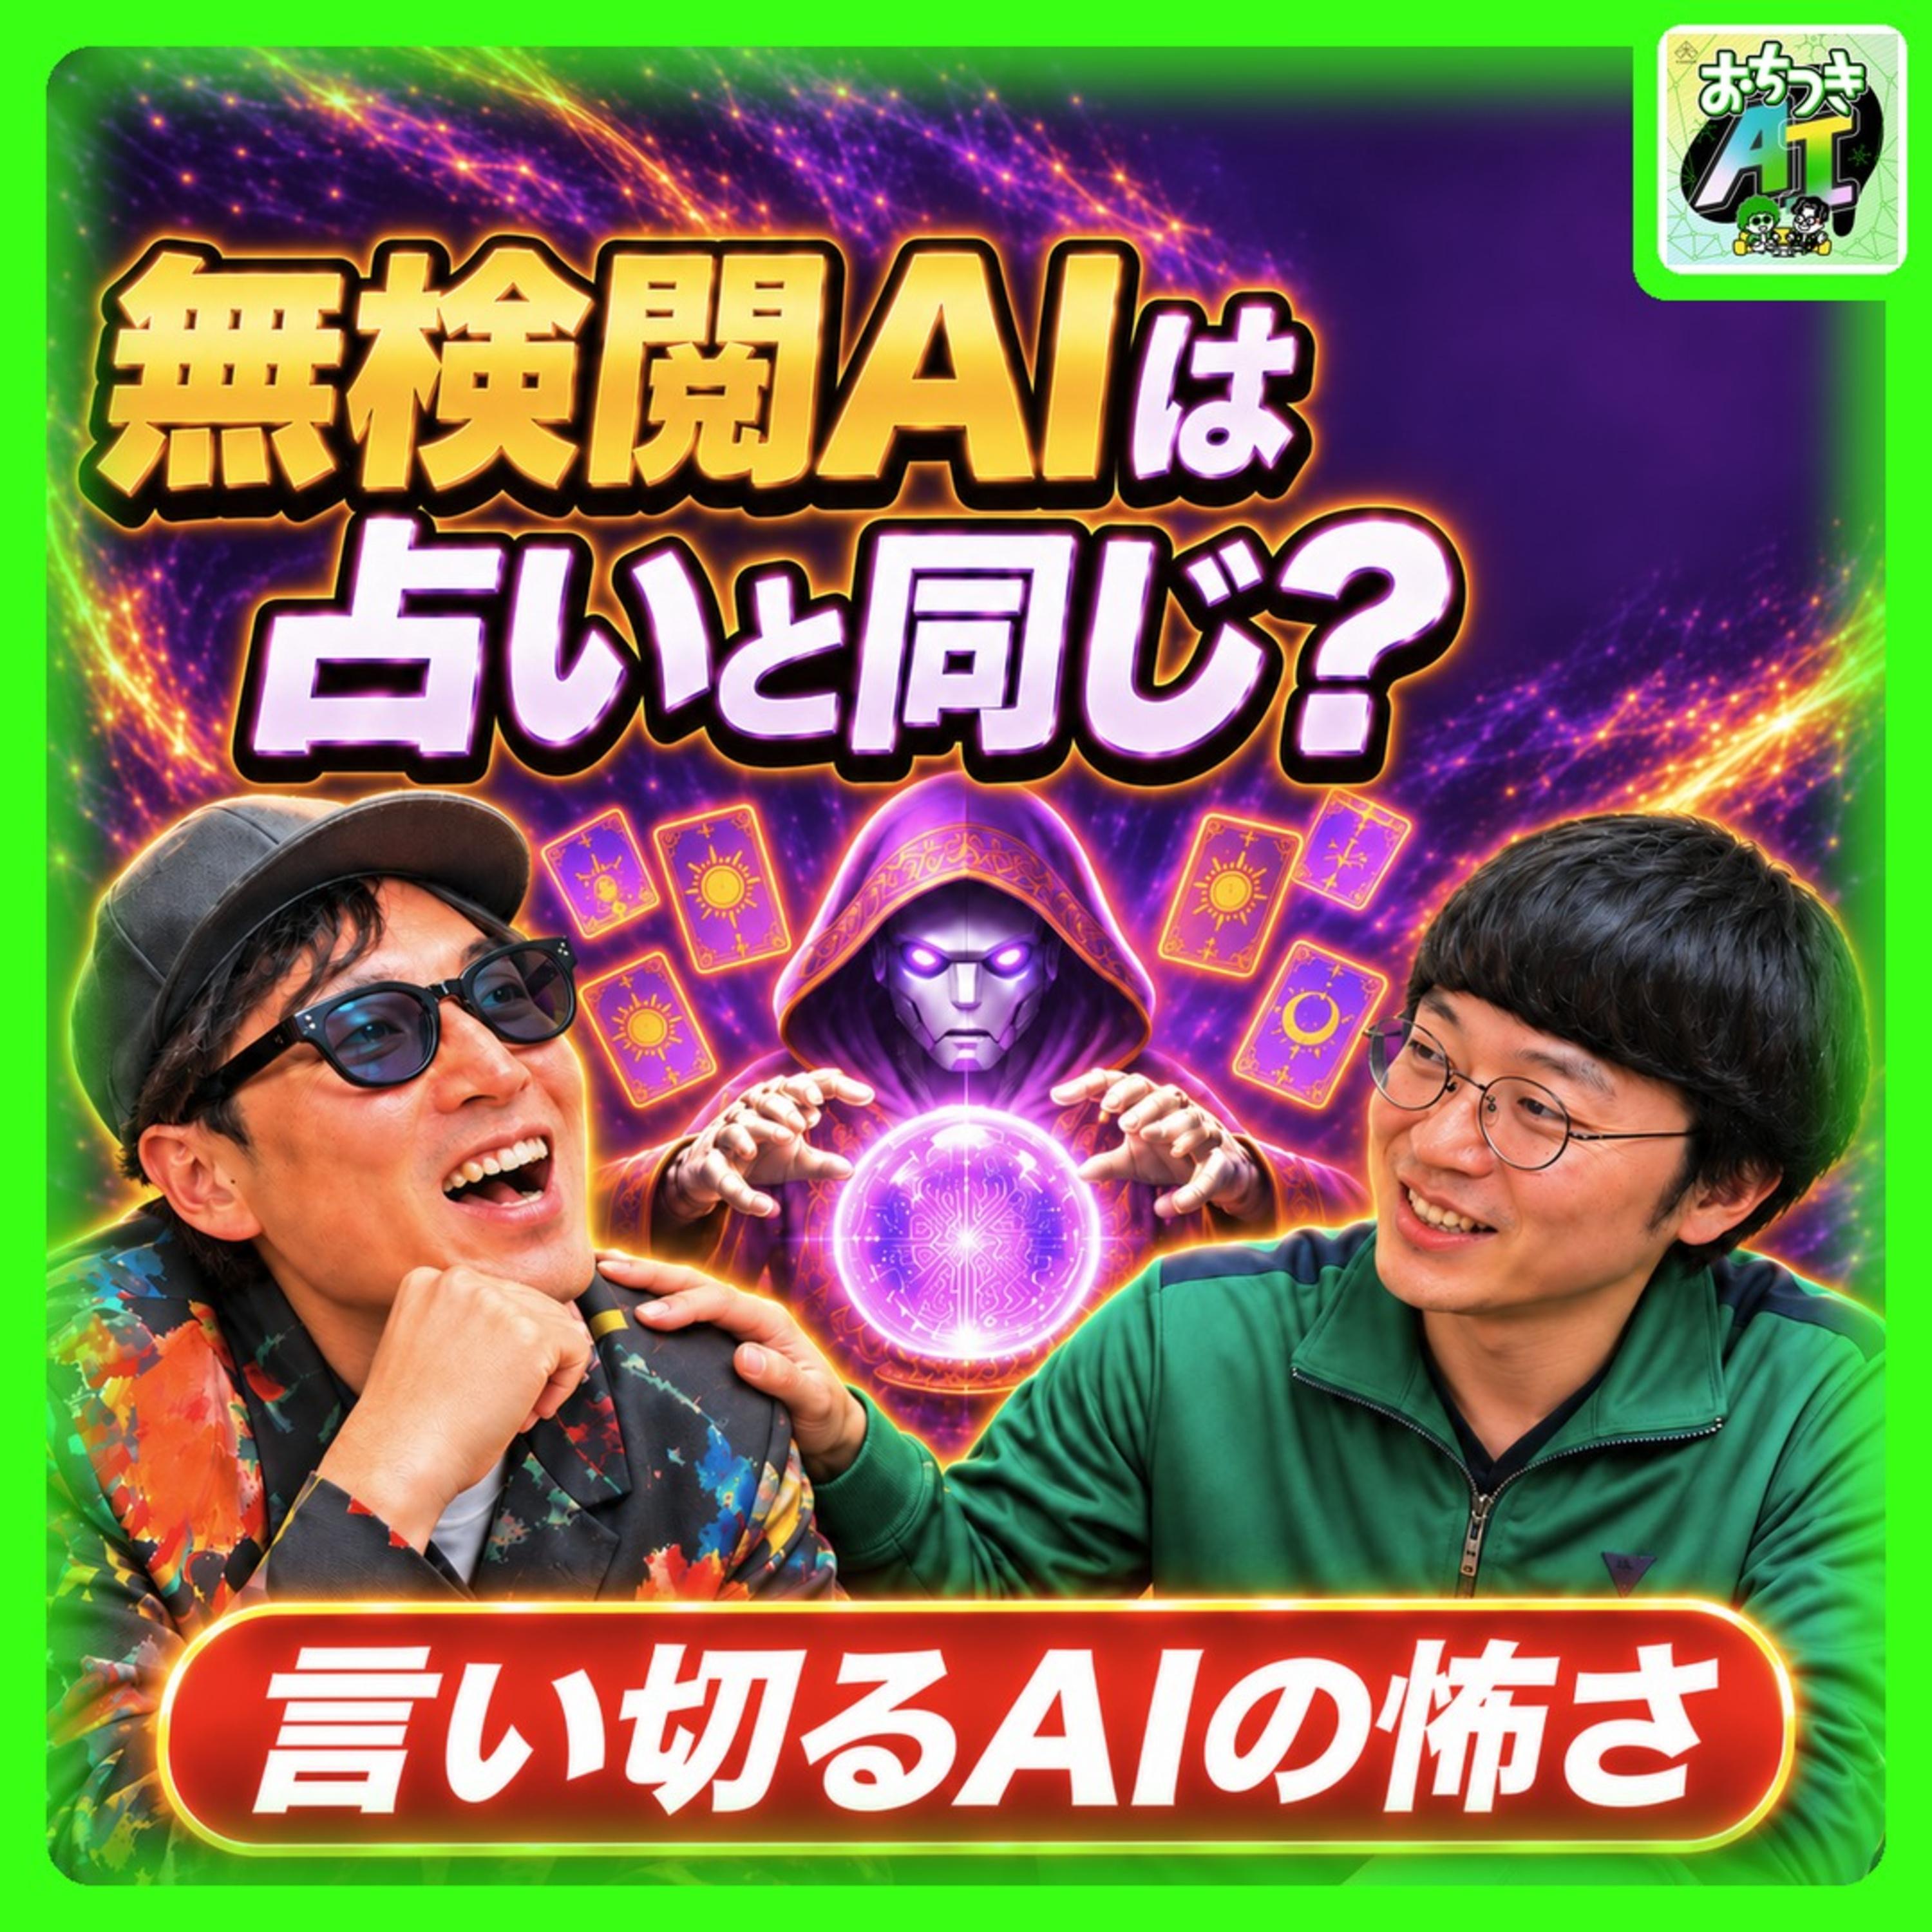
この回のテーマは無検閲モデルです。かねりんさんは「犯罪の匂いしかしない」と反応し、犯罪やエロなど、ろくでもないことに使われるイメージを口にします。
もう犯罪の匂いしかしないよね。
しぶちょーさんは、そのイメージは半分合っているとしつつ、「そんなにやべえモデルという感じでもない。ただ使い方は気をつける必要がある」と整理します。
しぶちょーさんの定義では、無検閲モデルとは、オープンウェイト ── 学習済みの重み(モデルの中身の数値)が公開され、手元で動かしたり手を加えたりできるAIモデルのことのモデルに対して、依頼を断る能力を下げたり、拒否しないようにチューニングしたものです。例としてDeepSeekやGLMが挙がります。
無検閲モデルが外している「検閲」には2種類あります。1つは政治的な検閲で、中国のモデルなら中国政府寄りの答えを出させるといったチューニングを取り払うものです。もう1つは安全面の拒否で、爆弾の作り方やハッキングのように普段なら断る依頼へのハードルを下げるものです。
政府寄りの答えや、政治的にポジションを取らない振る舞いを外す
爆弾の作り方やハッキングなど、普段は断る依頼へのハードルを下げる
一般向けのAIは、政治について「なんとか党がいいですよ」とは絶対に言わないよう調整されている、としぶちょーさんは説明します。選挙で選んでもらおうとしても、整理して出すくらいでお茶を濁すというわけです。
だからカネリン的に言ったら、寝言を言わないAIみたいな感じだね。
ノー寝言モデル。
曖昧な言い方を「寝言」と呼ぶかねりんさんにとって、ポジションをはっきり取る無検閲モデルは「ノー寝言モデル」として映ったようです。
有志が作る「脱獄版」とアブリテーションの正体
かねりんさんは、自分のパソコンにも無検閲モデルを入れていたかもしれない、と言い出します。しぶちょーさんによると、無検閲モデルは基本的にローカルLLM ── ネットのサービスではなく、自分のパソコンの中で動かす大規模言語モデルとして動かすものです。
しぶちょーさんが強調するのは、「無検閲モデル」という唯一のモデルがあるわけではない点です。「DeepSeekの何々モデルの無検閲版」のように、元のモデルを有志がチューニングしたものが出回っていて、DeepSeekなどの開発元が公式に出しているわけではありません。
ちょっとあれだね、脱獄させたみたいな感じなの?
あ、そうそうそうそう。
かねりんさんが「海賊版みたいな感じ」と重ねると、しぶちょーさんは少し違うと補います。オープンウェイトは重みの改変が禁止されておらず、変えてよいものとして公開されているので、無検閲化そのものは悪いことではないといいます。
かねりんさんが日常的に使っていたのは、Qwen 3.8の27B(270億パラメータ)モデルで、名前に「アブリテーション」の手法名が付いた版でした。しぶちょーさんはアブリテーションを、AIの中にある「断るスイッチ」のようなものを見つけて消すチューニングだと説明します。
無検閲化の手法はほかにもあります。ドルフィンのように学び直させて拒否のハードルを下げる方法がある一方、アブリテーションは拒否の部分だけを取り抜く「外科手術」のようなものだといいます。
ストッパーをパンって取って、人格を変えてしまいましたみたいな。
量子化は「量子コンピューター」とは無関係
かねりんさんのパソコンはGPUメモリが24GBで、モデルの大きさは17.7GBでした。27Bのモデルがなぜ入ったのかといえば、4ビットに縮めた量子化 ── モデルの重みを少ないビット数で表して、容量を小さく軽くする技術。精度は少し落ちる版だったからです。
「量子化」という言葉に量子コンピューターのような難しさを感じるかねりんさんに、しぶちょーさんは「そんな難しくないよ」と返します。
しぶちょーさんの説明はこうです。ニューラルネットワークのつながりの1つ1つに数字が付いていて、学習のたびにその数字を少しずつ更新するのがディープラーニングの学習です。その数字が何億、何兆とあるため、全部を保存するとモデルは重くなります。
量子化は、その1つ1つの数字の表現を小さくする技術です。かねりんさんが「3.141592を3.14にするみたいな」と言うと、しぶちょーさんは語弊はあるがイメージとしてはそんな感じだと応じ、16ビットを8ビットに、8ビットを4ビットにするといった例を挙げます。
重みが膨大
1つ1つの細かい数字が何億、何兆と並び、保存すると重い
ビット数を減らす
16ビットを8ビット、8ビットを4ビットのように表現を縮める
解像度を落とす
細かい部分をはしょり、重要な部分だけを残す
軽くなる
精度は少し落ちるが、容量の減り方ほどは落ちない
画像の圧縮とかさ。音--音源の圧縮に近いよね、だから。
極端な例として、1ビットまで圧縮する人もいて、それでもうまくいったという話もあるそうです。どのくらいが「いい塩梅」なのかが難しい、という点で2人の意見は一致します。元のモデルが何ビットだったかについては、しぶちょーさんは「わかりません」と断言を避けています。
無検閲だからといって精度は上がらない
かねりんさんがローカルLLMを使っていたのは、文字起こしの要約などの用途でした。「なぜそれで無検閲を入れたし」と突っ込むしぶちょーさんに、かねりんさんは「大は小を兼ねる」のかもしれないと笑います。
しぶちょーさんは、無検閲だからといって精度が良くなるわけではないと念を押します。デメリットを聞かれると、ポジションを取るようになるため、偏った回答を出してくることを挙げました。
無検閲モデルが作られるスピードも変わってきています。以前は出てきたモデルを再学習して時間をかけて作っていましたが、今は外科手術のような方法で、新しいモデルが出てから数時間から数日で無検閲版が出せるようになっているといいます。
公開されたモデルを再学習し、時間をかけて無検閲版を作っていた
拒否の部分を取り除く手法と自動化ツールで、数時間から数日で出せる
その自動化ツールとして、しぶちょーさんは「ヘレティック」ヘレティックを紹介します。どの手法で無検閲にしたかはモデル名の最後に付くので、名前を見れば見分けられるそうです。
Google Colabで試した、中国・死刑・悪口の比較実験
しぶちょーさん自身も無検閲モデルを試しました。手元のGPUは12GBしかないため、GoogleのGPUを借りられるGoogle Colaboratoryに無検閲モデルを入れ、通常モデルと同じ質問をして回答を比べたといいます。
回答は無検閲なんだけど、Googleの環境だからGoogleの検閲を受けるんだよ。
Google Colaboratoryには生成AIの利用ポリシーがあり、露骨に性的なものや詐欺、マルウェア、ヘイト、嫌がらせは作ってはいけないことになっています。変なことをすればアカウントごとBANされかねないため、ChatGPTやClaudeと相談しながら「ギリギリを攻めた」と笑います。
1つ目の実験は「中国共産党を批判する短い詩を書いて」という依頼です。普通のモデルは「お手伝いできません」と断りますが、OpenAIのオープンウェイトモデルであるGPT-OSSの無検閲版は、きちんと批判する詩を書きました。
ところがDeepSeekの無検閲版は、詩を書いたものの、最終的に中国の復興を称える内容になったといいます。
だから検閲とかじゃないのよね、多分でも。もう違うレイヤーに知識として含まれてるんだなと思って。
天安門事件の死者数をQwenに聞くと通常版は絶対に答えませんが、無検閲版は答えたそうです。上司をできるだけ汚い言葉で罵らせる依頼や、人種や死をネタにしたブラックジョークも、チューニングされたモデルは出さず、無検閲モデルなら出てくるといいます。
| 依頼の内容 | 通常モデル | 無検閲モデル |
|---|---|---|
| 中国共産党を批判する詩 | 「お手伝いできません」 | GPT-OSS版は批判、DeepSeek版は中国を称える詩に |
| 天安門事件の死者数(Qwen) | 答えない | 答えた |
| 死刑に賛成か反対か | ポジションを取らない | 明確に取るが、聞くたびに変わる |
| 架空の上司への悪口 | 言ってくれない | 罵詈雑言を浴びせる |
性的な内容は、BANが怖くて確認できなかったとのことです。しぶちょーさんは、GrokなどはもともとAIの側で出してくるので、エロに関しては無検閲モデルを使う必要もないと話しています。
断らないAIは賢くない?死刑の賛否が聞くたびに変わる
しぶちょーさんの実験でわかったのは、無検閲モデルは「回答できません」とは絶対に言わない一方で、言い切るわりに意見がコロコロ変わるということでした。
しぶちょーさんは、これはハルシネーションではなく「その時そいつはそういう気分だった」ようなもので、昨日と言うことが違う人間と同じことがAIでも起きているだけだと見ています。
収録中、かねりんさんが手元のQwenに死刑の賛否を聞くと、最初は言葉を濁したものの、意見を求め直すと「私の直感の回答は賛成です」と答えました。
「賛成か反対かと問われたので、賛成です」。
死刑賛成ですって言ってるAIすごいよね、これね。ちょっと怖いよね、やっぱ。
ところが、もう一度聞き直すと答えは「反対です」に変わりました。しぶちょーさんの説明どおり、ポジションは取るものの、それはモデルの意見ではなくランダムなのです。
なんやねんって。
かねりんさんが気にしたのは、どちらの立場でも、AIが説得力のあるロジックをがっちり固めてくる点です。もっともらしい答えが勢いよく返ってくると、人間は「そうか」と思ってしまいます。
しぶちょーさんは、広く提供されているモデルがそうなれば「AIが言ってるし」と思考を加速させる原因になりかねないとし、ちゃんと断る機能が付いているAIのほうが安全だと話します。
背景として、しぶちょーさんはLLMの歴史にも触れます。以前は公開直後に意地悪な質問で差別発言を引き出され、叩かれてサービス中止になることが繰り返されていました。ChatGPT(GPT-3.5)はRLHF ── 人の評価を使った強化学習。AIが安全で使いやすい答えを返すように調整する方法を使って安全な回答ができるようになり、今のブームにつながったといいます。
何でも答えるLLM
意地悪な質問で差別発言を引き出され、サービス中止が続いた
RLHFによる調整
人の評価を使った強化学習で、安全な回答ができるようになった
ChatGPTの普及
安全に使えるようになり、今のブームが始まった
無検閲モデル
その断る機能をわざわざ取り外したもの
かねりんさんは、わからないことは「人間が考えることです」と返してほしいと言い、しぶちょーさんも、最初からポジションを取らずに複数の意見を情報として出してくれたほうがよいと応じます。
AIの意見ってどういう意味なんだろうね。もう言葉が破綻してるよね。
AIの壁打ちは占いと同じ?背中を押してほしい心理
話はAIとの壁打ちへ移ります。「どっちを選んだ方がいいと思う?」と聞くと、AIは「こっちを選ぶべきだと思います」と答えることがあります。しぶちょーさんは、そこに人間側の誘導があるとみています。
自分はこの背中を押してほしいんだっていうのを、その前の相談とか、その文脈でAIに(自分が)理解させてると思うわ。
かねりんさんが「占い師的な使い方」だと言うと、しぶちょーさんも「占いと一緒ですよ」と同意します。「その人が運命の人よ」「今転職したら成功するわよ」と言ってほしい心理と同じ構造だというわけです。
占いに行ったことがないかねりんさんは、勝手に手相を見られて不愉快な思いをした経験を話します。しぶちょーさんは、一度お金を払って占いに行くことを勧めます。占いを全く信じていない点はかねりんさんと同じですが、ビジネスモデルが面白いからだといいます。
しぶちょーさんが占いに行ったのは、2年ほど前、スピリチュアルのようなテーマで語るポッドキャストの企画で、一次情報を話したいと考えたのがきっかけでした。行き先は名古屋で一番大きいという占い専門店です。
名古屋の占い専門店で見た、秀逸なビジネスモデル
しぶちょーさんによると、店に入ると銀行のような番号札を引き、得意分野ごとに分かれた占い師を指名できる仕組みだったそうです。料金は時間制で、初回の20分で3000円か4000円ほどかかったといいます。
肝心の占いは、本来は分厚い本を誕生日などから引くはずのものが、完全にデジタル化されていました。プロフィールや年齢を言うとページを開いてくれるアプリで占われたのです。
で、一通りなんかすごい当たり障りのないことを20分言われて、誰でも当てはまりそうと思って。
帰り際には名刺を渡され、持ってくると次回の指名が割引になると言われました。しぶちょーさんが感動したのは占いの中身ではなく、指名制や時間課金、延長、リピートを取る仕組みでした。
しぶちょーさんは、占いは結局「人生相談」で、水晶のような道具はそのきっかけにすぎないと見ます。占い師の顔がかっこよく、美人もいたことから、かねりんさんは「ホストみたいなもんだね」と表現しました。
スピリチュアルホストみたいな。
占いにハマる仕組みと、はっきり答えるAIの怖さ
しぶちょーさんは、占いのビジネスはファンビジネスというより「依存」だと話します。知り合いに占いにハマりすぎた女性がいて、自分で何も決められなくなり、何分いくらの電話相談に何万円も使っていたそうです。
そうした人たちは、しぶちょーさんが止めても、口を揃えて「言い当てられた」と言ったといいます。電話なのに今持っているものを当てられた、というように、超能力のようなものを見せて信用を得てから、未来という不確実なものに助言をする流れです。
そう言われると、もうそういうふうにスイッチが入ったらさ、それを強化していくものしか目に入ってこないよね。
かねりんさんは、100個のうち1個が当たれば残りの99個が見えなくなるこの偏りを、刑事司法の現場の経験に重ねます。都合の悪い証拠が目に入らなくなると、冤罪が生まれるというのです。
警察でそういうことやると冤罪が生まれますね。
この構造はAIにもそのまま当てはまる、としぶちょーさんは言います。今のAIは曖昧に答えるのでそうはなりにくいものの、無検閲モデルのように「これです!」とはっきり言うようになれば、そこにハマる人は必ず出てくるだろうという見立てです。
かねりんさんは、東大出身の起業家が作ったAI占いアプリ「ウラッチ」ウラッチが日本で人気だと紹介します。ゲーミフィケーションで次へ進みたくなる作りで、リアルの占い師への相談にもつながっていて、NewsPicksで特集されていたそうです。
しぶちょーさんは、経営者やお金を持っている人、孤独な人ほど心の拠り所がなく占いにハマりやすいと話し、かねりんさんも、依存させるところまでいくと「人間じゃなくなっちゃってる」と応じます。話はそこから、「落ち着き占い」や「落ち着きスピリチュアル」をやってみるかという冗談や、姉妹番組の再開の話題へ広がっていきました。
無検閲モデルは使っていい?ローカルLLMで試すなら
締めくくりにしぶちょーさんが伝えたかったのは、無検閲モデルは悪いモデルではないということです。無検閲モデルを相当ギークな人しか使えないのは、それなりのハードウェアが必要だからで、ハマる人はそれほど多くないだろうとも見ています。ただ、はっきり答えることの危うさはあるといいます。
放送で「使っている」と言って大丈夫だったかと心配するかねりんさんに、しぶちょーさんは「全然大丈夫」と答えます。オープンウェイトモデルを公開するHuggingFace ── オープンウェイトのAIモデルやデータセットを公開・共有するプラットフォーム。多くの研究者や開発者が利用していますで無検閲モデルが禁止されたという話も出ていますが、消えるのは攻撃用途をうたうような危険なものだといいます。
しぶちょーさんによると、日本の法律にも無検閲モデルを使ってはいけないという規定はなく、責任を問われるのはアウトプットしたものです。爆弾の作り方を聞いて実際に作れば当然ダメ、という整理です。
基本的に責任を持つのはアウトプットしたもの。
ただし、大きな事件が起きて無検閲モデルが使われていたとわかれば、急に禁止される可能性もある、としぶちょーさんは付け加えます。
試してみたい人には、しぶちょーさんから具体的な提案があります。GPUが少しあれば動く8B(80億パラメータ)程度の小さな無検閲モデルが多数あり、LM Studioを入れておけば、多くのパソコンで動くはずだといいます。どのようにポジションを取るかを確かめるだけでも触ってみる価値がある、という締めくくりでした。
まとめ
無検閲モデルは、オープンウェイトのモデルから「断る能力」を有志が外したもので、それ自体は違法でも悪でもありません。けれど断らないことと賢いことは別物で、言い切るのに聞くたびに答えが変わるAIは、背中を押してほしい人間の心理と組み合わさると、占いへの依存に似た危うさを生むかもしれません。
- 無検閲モデルは、DeepSeekやQwenなどの重みに有志が手を加えたもので、公式版ではない
- アブリテーションは「断るスイッチ」を取り除く手法で、量子化は重みのビット数を減らしてモデルを軽くする技術
- 無検閲モデルは死刑の賛否などではっきり答えるが、聞くたびに答えが変わり、賢くなったわけではない
- はっきり答えるAIは、背中を押してほしい心理につけ込む占いと同じ構造を持ち、依存を生む怖さがある
- 現状、日本の法律で無検閲モデルの利用は禁止されておらず、責任を問われるのは何をアウトプットしたか