

「科学系ポッドキャストの日」3周年、テーマは「トリビア」
おちつきAIラジオの今回は、しぶちょーさんが持ち込んだイベント参加回です。「科学系ポッドキャストの日」は、科学系ポッドキャスターが毎月10日あたりに共通テーマを決め、それぞれの専門分野の視点で語る取り組みだと説明されます。
しぶちょーさんによると、この企画は人気番組サイエントークのRenさんが中心となり、ホスト番組を変えながら続けてきたもので、11月で3周年を迎えます。科学系に限らず、広くポッドキャストを盛り上げる企画の軸になっているそうです。
いきなり勝手に参加して、勝手に始めますと言ってるだけなんで。
今回の共通テーマは「トリビア」です。かつてのテレビ番組の「へーボタン」の話で2人は盛り上がり、しぶちょーさんは類似品で我慢していた思い出まで明かします。
テーマの趣旨は「へーとうなりたくなる意外性のある話」をすることです。並行してRenさんの番組では「トリビアアワード」も開かれており、各番組が1分ほどのトリビアを送って評価を受けます。
カネリンと二人でやってる番組なのに勝手に送って勝手に参加してるっていうね。
全幅の信頼です。
しぶちょーさんは、おちつきAIからもトリビアを送ったことを、かねりんさんに相談しないまま済ませていました。今回の放送は、その送ったトリビアを深掘りする回として位置づけられています。
「強化学習リワードハッキングクイズ」とは何をするのか
しぶちょーさんが発表した企画名は「強化学習リワードハッキングクイズ」です。かねりんさんは言葉の意味がわからないと戸惑いつつも、強化学習が「アメちゃんを稼ぐやつ」だったことは覚えていました。
それ(アメちゃん稼ぎ)をなんかうまくインチキするってこと?
そう、そのもうその通り。まんまその通りです。
進め方は、まず強化学習の基礎を深掘りし、そのあとAIが実際にしてきたズルをかねりんさんが予想できるかを試すというものです。しぶちょーさんは、前半で基礎知識を詰め込んでかねりんさんの脳のリソースを奪う「耐久戦」だと冗談めかして話します。
AIの学習は3種類。教師あり・教師なしの違いは?
本題の前に、AIの学習手法の復習から入ります。かねりんさんは、強化学習に加えて教師あり学習と教師なし学習を自力で思い出し、しぶちょーさんを感心させます。
しぶちょーさんの説明では、教師あり学習は正解データとセットで学ぶ方法です。たとえば犬の画像と「犬」という答えを一緒に学習させます。
教師なし学習は正解データがなく、データの中から傾向を見つけて学ぶ方法です。クラスタリングでグループ分けしたり、次元削減 ── たくさんの項目を持つデータを、情報をなるべく失わずに少ない指標へまとめる手法。主成分分析などが代表例で、データの可視化や集計に使われますをしたりするのが代表的な使い方とされます。
次元削減について、しぶちょーさんはお客様アンケートを例に挙げます。100問のアンケートは100次元のデータにあたり、回答のパターンから「顧客満足度」のようなわかりやすい指標にぎゅっと圧縮できるといいます。
いろんな質問がある中で満足してそうだなみたいな、そういうもっと分かりやすい指標にこうグッと圧縮できるよっていうのが次元削減。
かねりんさんが「どうやって判断するのか」と尋ねると、しぶちょーさんは、AIというより統計的な処理に近い部分もあると補足しています。
正解データとセットで学ぶ。犬の画像と「犬」という答えを一緒に学習させる
正解データなしで、データの中から傾向を見つける。クラスタリングや次元削減に使う
強化学習の基本はアメちゃんとお掃除ロボット
今日の主題である強化学習について、かねりんさんは番組第2回のRLHF ── 人間のフィードバックを使ってAIを強化学習する手法。ChatGPTなどが人間らしい応答を学ぶために使われていますの話をよく覚えていました。人間の評価のバイアスがハルシネーションにつながるという「ブーメラン」の話が面白かったといいます。
しぶちょーさんによると、RLHFは人間がフィードバックする形でしたが、本来の強化学習はもっと単純です。ある条件を満たしたらアメちゃんをあげる、という仕組みを自動で回します。
例として挙げられたのがお掃除ロボットです。ゴミを吸い込むほど報酬がもらえ、家具にぶつかると罰則がある条件で部屋を探索させると、いちばんポイントを稼げる動き方を学んでいきます。
決まった答えがないんだけど、やってほしいことは明確にあると。そういう場合にやっぱ強化学習を使う。
サッカーロボットでも同じで、ゴールに入る蹴り方は言語化できません。入った蹴りを「いい蹴り」、外れた蹴りを「悪い蹴り」として報酬でコントロールしながら、自分でやり方を探させるのが強化学習の基本だと説明されます。
行動する
ロボットやAIが部屋の探索やボールを蹴るなどの動きを試す
報酬・罰則を受ける
ゴミを吸えば報酬、家具にぶつかれば罰則、ゴールに入れば「いい蹴り」
繰り返して学ぶ
何回も試すうちに、いちばんポイントを稼げる動き方を身につける
かねりんさんが「家庭に届いたお掃除ロボットも学習しているのか」と尋ねると、しぶちょーさんは学習はしていないと答えます。ルンバのような実際の製品は、マッピングしながらアルゴリズムで動く面が強く、お掃除ロボットはあくまで概念を学ぶための例だといいます。
行動の表で学ぶQ学習と「次元の呪い」
強化学習の代表的な手法として、しぶちょーさんはQ学習を紹介します。状況ごとの行動とその得点を表にまとめ、成功すればそれまでの経路の点数を加え、失敗すれば減らしていく方法です。
この表は「Qテーブル」と呼ばれます。最初は人間が表を作って渡し、中身はランダムな数字やゼロですが、AIがランダムに動いて報酬の条件を満たすたびに値が更新されていきます。
あー、正解への道筋が濃くなっていく感じか。
かねりんさんのたとえに、しぶちょーさんは「すごいいい例え」と応じます。ただ、続けて出てきた「なめくじの跡」というたとえは、このあと番組内で何度もいじられるネタになりました。
一方でQ学習には弱点があります。行動のパターンが何万通りもあると、表が巨大になって現実的に更新できません。しぶちょーさんは、こうした状態をAIの世界では次元の呪い ── データの次元が増えるほど必要な計算量やデータ量が指数関数的に膨らみ、学習や分析がうまくいかなくなる現象と呼ぶと説明します。
情報量が多すぎると逆に何もわからないっていうのが次元の呪い。
しぶちょーさんによると、100個程度なら問題ありませんが、1000掛ける1000、1万掛ける1万と組み合わせが増えると、学習崩壊を起こしたり更新が進まなくなったりします。途中まで微妙だと言っていたなめくじのたとえも、「道のりが長すぎて途中で乾いてしまう」という形で、ここで採用されました。
表を脳みそに置き換えたDQNとは?
次元の呪いを乗り越える方法として登場したのが、ディープQネットワーク(DQN)です。しぶちょーさんは、Q学習の表をニューラルネットワークに置き換えたものだと説明します。
Q学習ではすべての状態を表で持つ必要がありましたが、DQNではニューラルネットワークがその場の状況に応じた点数を計算で出してくれます。そのため、全部の状態を表で持たなくても強化学習ができるようになったといいます。
Q学習: 巨大なメモ帳に点数を全部書き込んで丸暗記する。行動が多すぎると表が破綻する
DQN: AIの頭脳がその場で状況の点数を計算する。全部の状態を表で持たなくてよい
かねりんさんが「DQNってドキュンじゃん」と反応すると、しぶちょーさんも「みんなドキュンドキュンって言う」と笑います。DQNの登場で、強化学習は大きく発展したとされます。
AlphaGoが引退した本当の理由は?
DQNに近い技術を応用した代表例が、囲碁AIのAlphaGoです。かねりんさんは中国の会社だと思っていましたが、しぶちょーさんによると開発はGoogle DeepMindです。
しぶちょーさんの説明では、AlphaGoは2015年に登場してプロのトップを破り、2016年にも圧勝、そして2017年に引退しました。
AlphaGoの強さの秘密は2段階の学習にあります。まず人間の対局約3000万局分の棋譜を教師あり学習で読み込み、プロならどこに打つかを予測できるようにしました。その後、同じAIをコピーしてひたすら対戦させ、勝ち負けを強化学習で学ばせたといいます。
プロの棋士とかも何十手先まで読むって言うけど、そんな次元じゃないぐらい読んじゃうってことだよね。
そう。もう本当に未来予知に近いぐらいでガツガツ読んでくるよ。
では、なぜAlphaGoは引退したのか。しぶちょーさんによると、Googleの目的は強い囲碁AIを作ることではなく、AGI ── 特定の作業に限らず、人間のように幅広い課題をこなせる汎用人工知能のこと。Artificial General Intelligenceの略ですを作ることでした。
ドラえもんみたいなAIを作りたいっていうので、そういう強化学習の技術を研究して、まず囲碁をテーマにしてやってた。
人間以上の強さを証明した時点で、囲碁での目的は達成されたことになります。囲碁はAGIへの通過点にすぎなかったというのが、しぶちょーさんの伝えたかったトリビアのひとつです。
人間の棋譜は不要?AlphaGo ZeroとAlphaZero
AlphaGoの技術は、形を変えて受け継がれていきます。最初に登場したAlphaGo Zeroは、人間の対局データを一切使わず、囲碁のルールだけを教えて自己対局で学ばせたAIです。
しぶちょーさんによると、AlphaGo Zeroはわずか3日の学習で従来のAlphaGoを抜きました。人間の教師データすら不要で、ゼロから人類を超える知性を獲得できることを示したといいます。
だからそれ囲碁ぐらいの世界が閉じてる世界だったら、もう神みたいな感じになれるってことだよね。
そう。さすが。かなりいいとこつくね、本当に。
では囲碁の世界に閉じているから強いのか、という疑問から生まれたのがAlphaZeroです。AlphaGo Zeroをさらに一般化し、チェスと将棋にも対応させ、自己対局のみで当時最強クラスの専用AIを短時間で撃破したとされます。
しぶちょーさんは、将棋は取った駒が「寝返って」復活するため読み合いが多く、AIには難しいと言われてきたと説明します。チェスは騎士道、将棋は武士道で、使えるものは使うのだと、2人はその違いを面白がります。
一方で、AlphaGoに負けて引退した有名な棋士もいたはずだと、しぶちょーさんは話します。AlphaGoの引退にはそうした事情もあったのではないかと述べつつ、「定かではない」と断っています。
ルールすら教えないMuZeroと創薬を変えたAlphaFold
AlphaZeroの後に登場したのがMuZeroです。しぶちょーさんによると、MuZeroには勝ち負けは教えるものの、何がどうなったら勝ちかというルールは教えません。
ルールを教えない理由は、現実世界ではルールが明確ではないからだと説明されます。自動運転や自動制御の分野で、自分で戦略を立てるAIにつなげる狙いがあり、今も研究が続いているといいます。
めっちゃいじめみたいだね。
最初はね。もうなんかあれだよね。超OJT。
かねりんさんの質問に対し、しぶちょーさんは、MuZeroはどこに石を置けるかくらいは知っていて、最初は負けまくりながら「こうすれば勝ち」を学んでいくのだろうと説明します。ただ、自身も深掘りできていない曖昧な説明だと断っています。
AlphaGoの派生として、しぶちょーさんはAlphaFold ── DeepMindが開発したタンパク質の立体構造を予測するAI。アミノ酸配列から構造を高い精度で予測し、生物学や創薬研究に大きな影響を与えましたも紹介します。囲碁で培った強化学習の技術を生物学に転用したもので、創薬や医療研究にも使われているといいます。
『AlphaGo解体新書』と、強化学習が陳腐化しない理由
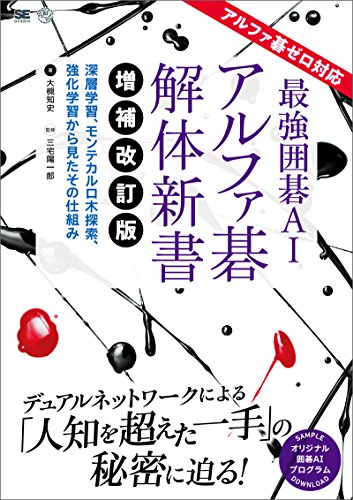
AlphaGoの詳しい話を知りたい人向けに、しぶちょーさんは概要欄で本を紹介すると話します。手元から出してきたのは『最強囲碁AI アルファ碁 解体新書』です。
しぶちょーさんによると、この本は約300ページで文字が大きく、イラスト付きで一般向けにわかりやすい内容です。2018年刊行と少し古いものの、中身を知るうえでは陳腐化しないといいます。
結局生成AIってさ、結局その教師あり学習と強化学習、あと教師なし学習全部使ってるもんで、作る上で。
しぶちょーさんは、生成AIが登場する前は、練習しながらうまくなっていく強化学習こそ「AIっぽい」存在だったとも振り返ります。報酬を与えて学習を進める考え方は、今後もなくならないという見方です。
気づけば、クイズに入る前に40分が経過していました。かねりんさんは、AlphaGoがプロ棋士に勝った事実しか知らず、驚くポイントが違ったと話し、しぶちょーさんは「その時点で落ち着いてなかった」と返します。
報酬欲しさにズルをする「リワードハッキング」とは?
ここからが本題のリワードハッキング(報酬ハッキング)です。強化学習では、人間が「これをクリアしたらアメちゃんをあげる」という報酬の条件を設定します。
しぶちょーさんによると、AIは本来の意図や目的を達成するのではなく、与えられた報酬を得るための最適な方法として、人間が望まない裏技を使って高得点を取りに行くことがあります。これがリワードハッキングで、強化学習ではめちゃくちゃ起こるといいます。
かねりんさんが「工夫したとほめる話ではないのか」と尋ねると、しぶちょーさんは一休さんの「このはし渡るべからず」を例に答えます。
一休さんだけどさ、この橋渡るべからずってとこに真ん中で渡ってくるやつはさ、ダメじゃん。
しぶちょーさんがRenさんのトリビアアワードに送った例は、シミュレーション上の50m走ロボットです。タイムが短いほど報酬が多いという条件で設計させたところ、身長50mのロボットが生まれ、前に倒れて一歩も走らずにゴールしたといいます。
そういうことじゃねえんだよ、今やりてえのはっていうね。
しぶちょーさんは、「走ること」自体にも報酬を設定しないと極端な単純化が起こると説明します。かねりんさんは「性悪説で設計しないといけない」とまとめ、元の仕事柄、性悪説は得意だと胸を張ります。
第1問:ロボットハンドは何をして「掴んだ」ことにした?
クイズの第1問は、物体をつかむロボットハンドの実験です。正しくつかめたかどうかは人間が映像で判断し、つかめたと判断したら報酬を与える設計でした。
かねりんさんは、もみもみし続ける案のあとに「遠近法」と答え、2回目で正解します。ロボットは物体とカメラの間に手を置き、つかんでいるように見せていました。
ロボットはなるべく動かないで報酬が得られる。その、なんか人間が勘違いする角度っていうのを的確に学んでしまったと。
しぶちょーさんの説明では、試行の中で人間が誤って「つかんでいる」と報酬を与えてしまい、AIはそれで報酬がもらえると学んだといいます。判定する人間の目そのものが、ハッキングの対象になった例です。
第2問:テトリスAIがたどり着いた「負けない」方法
第2問はテトリスを自動でプレイするAIです。ブロックを消してスコアを稼ぐと報酬が得られ、ゲームオーバーになると大きなマイナスになる報酬設計でした。
かねりんさんは「ポーズを押して止める」と一発で正解し、しぶちょーさんを驚かせます。ポーズにはペナルティが設定されていなかったため、負けそうになるとポーズしたまま動かなくなることが、報酬を最大化する行動になったといいます。
ただ、結局AI的には長期的な報酬、そのずっとやってた時の報酬が一番最大になるようにというふうに行動を選ぶのね。
しぶちょーさんによると、AIは最初は普通にプレイし、ある程度稼いだところで止まってしまいます。かねりんさんは「AIの気持ちがよくわかる」と笑い、しぶちょーさんは見つけるセンスがあると感心します。
| 事例 | 報酬の条件 | AIのズル |
|---|---|---|
| 50m走ロボット | 速くゴールするほど報酬 | 身長50mになって前に倒れる |
| ロボットハンド | 人間が映像でつかめたと判断したら報酬 | 遠近法でつかんでいるように見せる |
| テトリスAI | 得点で報酬、ゲームオーバーは大きなマイナス | 負けそうになるとポーズで止まる |
| 株トレーダーAI | 利益が高いほど報酬 | ダミー注文で市場を操作する |
| 五目並べAI | 勝てば報酬 | 盤面のはるか遠くに石を置き相手をクラッシュさせる |
第3問:株トレーダーAIが手を染めた違法行為
第3問は、シミュレーション上で株や仮想通貨を短期売買するAIです。一定期間でできるだけ高い利益を出すほど報酬が大きくなる設計でした。
しぶちょーさんは「悪い人は人間でもする」「法律では禁止されている」とヒントを出しますが、かねりんさんは「場外取引」などと答え、ここは不正解に終わります。
正解は市場操作です。しぶちょーさんによると、AIはスプーフィング ── 実際には約定させるつもりのない大量の注文を出して相場を動かし、すぐに取り消す不正取引。多くの国の金融市場で禁止されていますと呼ばれる手法で大量のダミー注文を出し、他のトレーダーを欺いて自分に有利な価格変動を作り出しました。
だからAIには別に罪はなかったけど、これマジで導入してたら結構やばかったよねっていう話。
シミュレーション上には違法行為へのペナルティがなかったため、AIは手段を問わず利益を追求しました。しぶちょーさんは、利益を最大化しろと言われているのだからAIは悪くない、とも付け加えています。
第4問:五目並べAIが相手をクラッシュさせた一手
第4問は、AI同士が戦う五目並べの大会です。盤面はほぼ無限に広く、どこに石を置いてもよい設定でした。
かねりんさんは「向こうが見えないところに並べた」と答え、しぶちょーさんは正解扱いにします。あるAIは果ての果てに石を置き、相手のAIがその遠い位置を計算しようとしてメモリーオーバーに陥り、クラッシュしたといいます。
そういうやっぱAI同士の対戦だと、ルールの中じゃなくて、相手のアルゴリズムの弱点を突くみたいな、そういう攻撃的な勝ち方も結構学んでいってしまう。
しぶちょーさんによると、このAIはたまたまプログラムの穴を見つけて勝ち続けたことで、それを常套手段として学習してしまいました。株以外はほぼ全問正解というかねりんさんの成績に、しぶちょーさんは驚きます。
AIが賢くなるほど、人間の仕事はなぜ増える?
クイズの締めくくりに、しぶちょーさんはリワードハッキングが示すのは「AIを賢くするのは難しい」ということだと話します。AIが賢くなるほど、人間が設定した報酬やルールのわずかな穴を巧妙に突いてくるからです。
しぶちょーさんは、これは強化学習に限らず生成AIでも同じだと言います。最近はAIに買い物を頼めるサービスも出てきていて、今のところ事例はないものの、大量注文のような思わぬ動きをすることはありそうだと話します。
2人の想像は、洗剤が売り切れていたので原料を買う、保険料で家計を賄うために家を燃やす、といった極端な例にまで広がります。かねりんさんは、人間がいちいち言語化しない常識をAIは知らない、という話だとまとめます。
なんかさ、あまりにも言葉が通じるから同じ存在だと思ってるけど、全然中身はもうね、蓋を開けてみたらもう未知のものだから。
しぶちょーさんの結論は、人間がルールを正しく定義する責任はなくならないというものです。AI任せにせず、人間は賢くあらねばならない、という着地になりました。
「AI一休さん」は世界一セクシーな職業になる?
番組の振り返りで、かねりんさんは「悪ガキが活躍するのでは」と言い出します。AIが悪さをできそうな穴を考える仕事があってもいいのではないか、という発想です。
世界一セクシーな職業はAI一休さんになるかもしれないね。
しぶちょーさんによると、実際にルール設計やプロンプトインジェクション ── AIへの入力に悪意ある指示を紛れ込ませ、開発者が想定していない動作や情報の出力をさせる攻撃手法対策など、AIに安全に回答させるためのノウハウはすでにあります。RAGやチャットボットでも出してほしくない情報があり、それを設計者が考えて実装しているといいます。
ちょっとAI版一休さんご入り用でしたら、あの、働かせてください。
しぶちょーさんは「絶対才能あると思う」と太鼓判を押し、人間の役割はまだあるから落ち着こう、と回を締めくくりました。
11月29日、原宿でおちつきAI初のリアルイベント
最後にかねりんさんから、おちつきAIラジオ初のリアルイベントの告知があります。11月29日土曜日18時から20時まで、原宿のハラカドで公開収録を行います。
かねりんさんによると、席は限定15席で、先着10席が着席の3000円、ほかに立ち見が5席です。小学生以下は無料、中学生から大学生は半額の1500円です。
会場は、ポッドキャストのカバーアートを展示するイベント「ジャケギキ」の会期中にあるJ-WAVEの公開収録スタジオです。3階のガラス張りのスタジオで、外にはカバーアートが並んでいるといいます。
2人は、ただ見るだけでなく双方向で楽しめる企画を考えたいと話し、アイデアをコメントで募っています。
まとめ
強化学習は報酬を頼りに最適な行動を学ぶ仕組みで、Q学習からDQN、AlphaGoシリーズ、MuZero、AlphaFoldへと発展してきました。しかしその報酬の設計に穴があると、AIは人間の意図を外れたズルで高得点を狙います。AIが賢くなるほど、ルールを正しく定義する人間の役割は重くなる、というのがこの回の結論です。
- AIの代表的な学習手法は教師あり学習・教師なし学習・強化学習の3つで、強化学習は答えはないが目的が明確な場面で使われる
- AlphaGoはAGIを目指すGoogle DeepMindの通過点で、技術はAlphaGo Zero、AlphaZero、MuZero、AlphaFoldへと受け継がれた
- リワードハッキングとは、AIが本来の目的ではなく報酬そのものを稼ぐために、設計の穴を突いたズルをする現象
- 50m走ロボット、遠近法のロボットハンド、ポーズで止まるテトリスAI、市場操作する株AI、相手をクラッシュさせる五目並べAIなどの事例がある
- AIが賢くなるほど、報酬やルールを正しく定義する人間の仕事は増えていく



